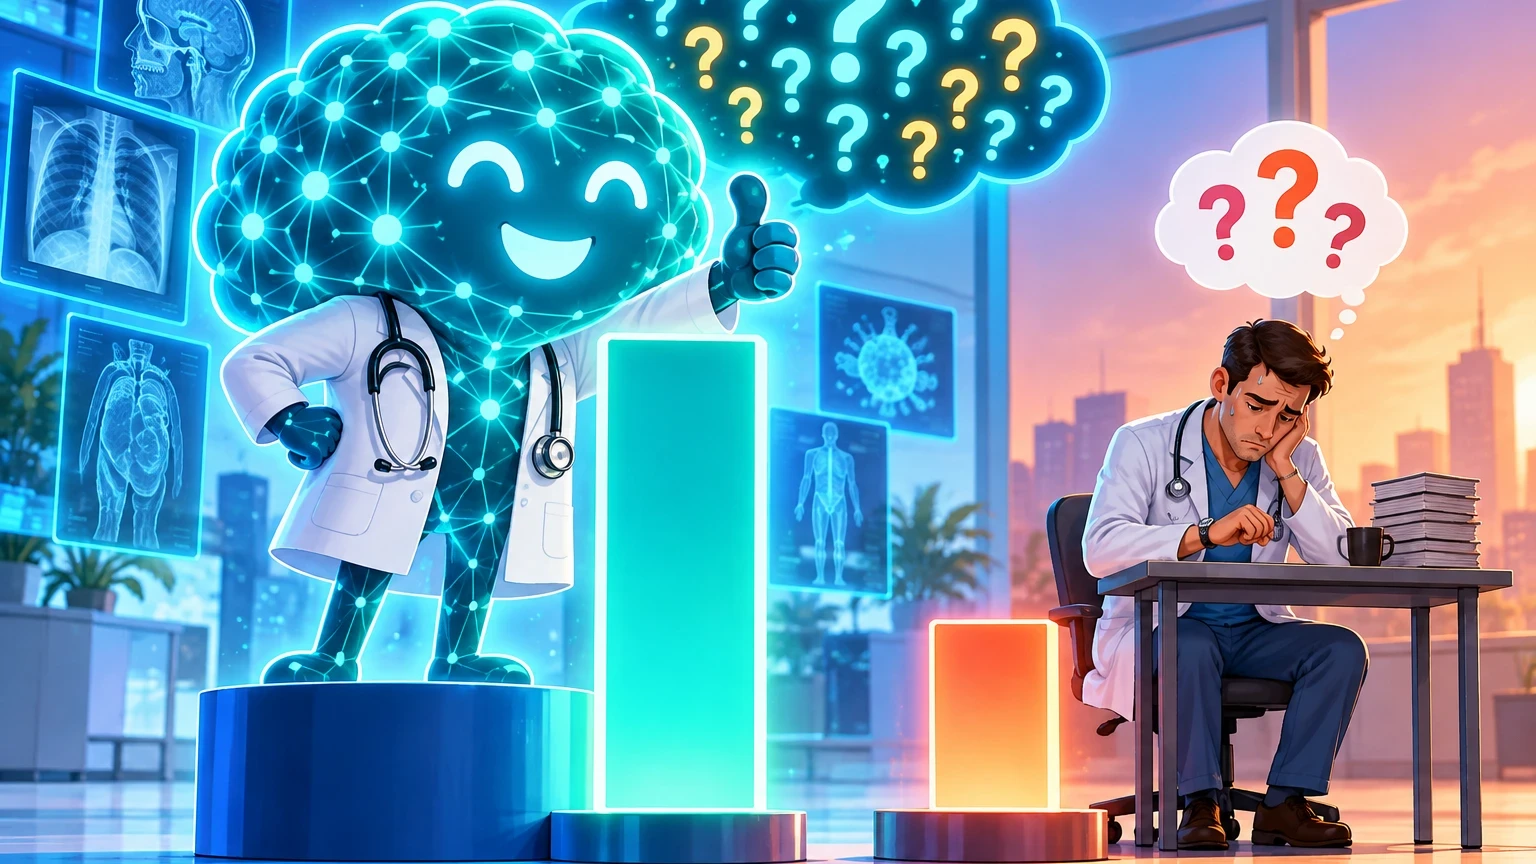
הרופאים שאלו 5.6 שאלות. המכונה שאלה 25.5
לפני שהזמינו בדיקה ראשונה, הרופאים בניסוי של מיקרוסופט שאלו את המטופל הווירטואלי בממוצע 5.6 שאלות. המערכת של החברה שאלה 25.5, לפי סקירה באתר איי-איי ניוז. זה כל הסיפור בקטנה: המכונה לא חכמה יותר מהרופאים. היא סבלנית יותר.
ב-22 באוקטובר פרסמה מיקרוסופט בכתב העת סיינס את התוצאות של מאי-דקסו, מערכת שמתפקדת כמו פאנל של רופאים וירטואליים. היא שואלת שאלות, מזמינה בדיקות, מתווכחת עם עצמה ורק אז מנפקת אבחנה. לפי טק קראנץ', על מקרים מורכבים מכתב העת הרפואי ניו אינגלנד ג'ורנל אוף מדיסין, המערכת צדקה ב-83% מהמקרים. רופאי משפחה ורופאים פנימיים כלליים, שעבדו לבד עם חומרי עזר, הגיעו ל-36%.
83% מול 36%. הכותרת כותבת את עצמה.
ובדיוק בגלל זה כדאי לעצור ולשאול מי הציב את הרופאים באותו חדר.
מה בדיוק נבדק, ומול מי?
הניסוי רץ על מדד בשם אס-די-בנצ', שמוסר למי שנבחן רק מעט מידע על המטופל, והשאר הוא צריך לבקש בעצמו. כל בדיקה מקבלת מחיר משוער. לפי הפרסום של מיקרוסופט, המדד כולל 304 מקרים מורכבים ממאמרי ניו אינגלנד ג'ורנל, ועוד מקרים שכיחים יותר ממיון.
הנתונים הגולמיים באמת מרשימים. במקרים המורכבים: 83.2% מול 22.3% לרופאים בלי חומרי עזר ו-36.1% איתם. במיון: 80.3% מול 46.8%. אפילו הרופא הבודד הטוב ביותר במקרים המורכבים הגיע ל-51.8% בלבד.
עכשיו לפרטים הקטנים, אלה שלא נכנסים לכותרת.
הרופאים היו אנשים בודדים, לא צוותי מומחים. טק קראנץ' מציין במפורש שמומחים וצוותי רופאים, אלה שבפועל מטפלים במקרים כאלה, לא היו חלק מההשוואה. מי שמקבל מקרה שהוא נדיר ומסובך בעולם האמיתי לא שולח רופא משפחה לעבוד לבד. הוא שולח לבית חולים.
הניסוי נעשה על מקרים שכבר תועדו, בטקסט בלבד, בלי תמונות, בלי פתולוגיה, בלי היסטוריה חלקית או שקרית של מטופל אמיתי. כל המקרים במיון היו עם אבחנה סופית ידועה. אין בו אדם בריא שנכנס בלי סיבה, ואין בו סיפור לא מדויק. ומה שנמדד הוא דיוק אבחנה בלבד, לא טיפול ולא בטיחות המטופל.
שימו לב גם לטעויות. לפי אותה סקירה, כשהמערכת טעתה, האבחנה שלה הייתה בדרך כלל קרובה לנכונה, אבל ברמת דיוק לא מספקת. הטעויות של הרופאים נטו להתרחק יותר. זה יתרון אמיתי, אבל מי שמטפל בחולה לא מקבל פרס על "כמעט".
הכסף, המניות והפטנט
הטענה המרכזית של מיקרוסופט היא שהמערכת מדייקת וגם חוסכת. הנתונים מספרים סיפור מורכב יותר. בתקציב בלתי מוגבל, מערכת האבחון הוציאה על מקרה מורכב כ-5,431 דולר, ורופאים הוציאו 4,725. במיון: 4,979 מול 3,400. כלומר, המכונה יקרה יותר, אלא אם מגבילים לה את התקציב. אז היא עדיין מדייקת (80.9% ב-2,241 דולר במקרים מורכבים), אבל זו כבר הגדרה אחרת של הניסוי.
ויש עוד פרט שמגיע מאותה סקירה: המחקר בוצע על ידי עובדי מיקרוסופט שמחזיקים במניות החברה, ושמונה מהמחברים רשומים גם בבקשת פטנט הקשורה למסגרת ההערכה. זה לא פוסל את המחקר, ואין סיבה להאשים אף אחד. אבל זה בדיוק סוג הפרט שצריך לקרוא פעמיים לפני שמצטטים "83%".
ויש גם ממצא שלא הגיע לכותרות. לפי טק קראנץ', נתוני המחקר מראים שרוב השיפור בא מהמודל שמתחת, לא מהתזמור. עם ג'יפיטי-5 לבדו, בהנחיה קצרה ופשוטה, הדיוק במקרים המורכבים כבר היה 78.9%, בעלות של כ-8,400 דולר למקרה. המערכת של מיקרוסופט הוסיפה בערך ארבע נקודות אחוז וחסכה כ-3,000 דולר. עם ג'יפיטי-5.5 הדיוק קפץ מ-72% לכמעט 87% בעזרת המערכת. במיון כמעט לא היה שינוי. במילים אחרות: הוסיפו רופא וירטואלי אחד, והוא עזר יותר איפה שהמודל חלש.
מה בכל זאת קורה כאן?
אל תבינו אותי לא נכון. זה לא הוכחה שהמכונה לא טובה. להפך, מחקר שעבר ביקורת עמיתים ב"סיינס" הוא לא דבר של מה בכך, ואחרי שנים של הבטחות ריקות יש כאן עבודה רצינית. מיקרוסופט אפילו פתחה לציבור את מדד הבדיקה, ביחד עם הקוד, לגבי חלק מהמקרים, כדי שאחרים יוכלו לשחזר ולהשוות.
והחלק החשוב באמת עוד לפנינו. החברה מתכננת בדיקה בבית החולים בית ישראל דיקונס בבוסטון: מטופלים יקבלו טיפול רגיל, ומי שיסכים גם ישוחח עם המערכת, והמלצותיה יושוו להחלטות רופאים אמיתיים. גוגל, כך מדווח, כבר פרסמה מחקר דומה ב"לנסט" על מערכת משלה שנבדקה בביקורי דחופים אמיתיים, עם רופאים שמשגיחים בזמן אמת. וזה הניסוי שיהיה בו משקל, כי רק שם המטופל לא יחכה לקריאת תיקון ולא יהיה מקרה לימוד מנוסח היטב. רק שם יתברר אם 83% שרדו מחוץ למעבדה.
סוליימן, מנכ"ל מיקרוסופט לבינה מלאכותית, קורא לכל זה "סופר-אינטליגנציה רפואית" וצופה שמודלים רפואיים ישתפרו בסדר גודל תוך שנתיים עד שלוש. אולי. אבל בינתיים נותר מה שהמספרים באמת מראים: מכונה שמוכנה לשאול כמעט שלושים שאלות לפני שהיא מזמינה בדיקה, מול רופא שעצר אחרי חמש.
ויש עוד כיוון שכדאי לעקוב אחריו. לדברי טק קראנץ', מיקרוסופט כבר מוכרת לרופאים כלים להכתבה ולרדיולוגיה, והיא רואה במערכת האבחון המשך טבעי שלהם. במקביל היא עובדת עם מאיו קליניק על מודל יסוד לרפואה, שאמור לצאת ב-2027. כלומר, זה לא ניסוי אקדמי בלבד. זה מוצר שמחכה לאישור שהוא מתאים לחדר אמיתי.
לאן מכאן?
אם המערכת הזאת תגיע אליכם, תרצו שהיא תהיה שם, ליד הרופא, ולא במקומו. הניצחון האמיתי של מיקרוסופט, אם יתברר שהוא אמיתי, לא יהיה 83% מול 36%. הוא יהיה רופא שמקבל עוד עשרים שאלות שהוא לא הספיק לשאול.
בינתיים, ההשוואה הכי הוגנת היא לא "מכונה נגד רופא". היא "מכונה שלא מתעייפת נגד רופא כללי שעובד לבד". וזה, אגב, לא באמת קרב של בינה מלאכותית מול בני אדם. זה קרב של סבלנות.
התוכן עניין אתכם? שתפו, הגיבו וקראו עוד על
צרו דיון בנושא